3.3. Classification des données géographiques #
La classification des données spatiales dans un SIG consiste à catégoriser l’information géographique en groupes ou classes distincts sur la base de caractéristiques ou d’attributs communs. Chaque classe peut se voir attribuer un symbole ou une couleur distincte. Ce processus améliore l’organisation et l’interprétation des données spatiales.
Les attributs des données géographiques sont stockés dans une colonne spécifique de la table attributaire. En pratique, nous choisissons une colonne contenant les caractéristiques qui nous intéressent, ce qui permet à QGIS de regrouper les données à partir de ces attributs sélectionnés (Fig. 3.8).
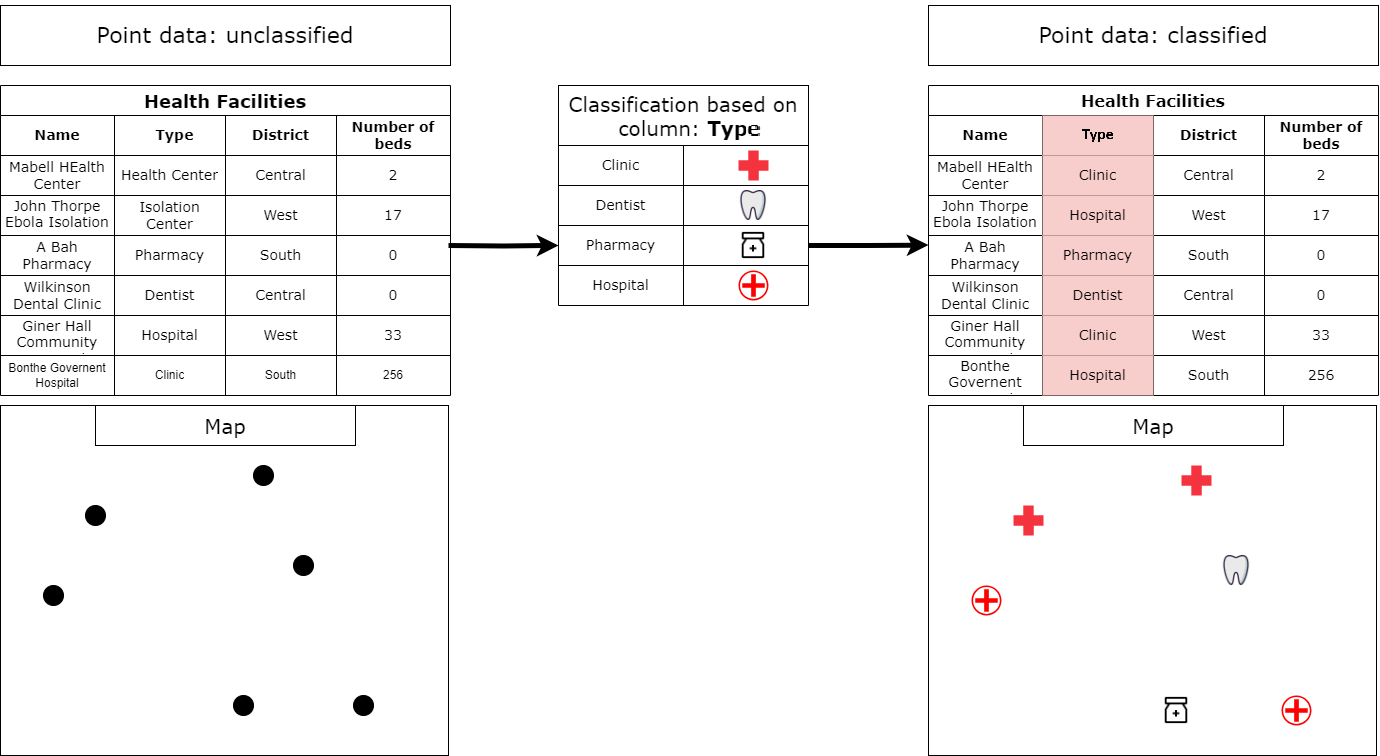
Fig. 3.8 Classification de base (Source : HeiGIT).#
3.3.1. Échelles nominale, ordinale et métrique #
Dans la classification des données géographiques, les échelles nominale, ordinale et métrique sont utilisées pour catégoriser et mesurer les entités spatiales selon différents niveaux de précision et de hiérarchie :
L’échelle nominale (données catégorielles) est la forme de mesure la plus simple, dans laquelle les entités sont regroupées en catégories distinctes sur la base d’attributs qualitatifs. Ces catégories n’ont pas d’ordre ni de hiérarchie intrinsèques. Elles n’ont pas de signification numérique : les valeurs ou les libellés sont simplement des noms ou des identifiants (dans certains cas, les classes d’occupation du sol peuvent être identifiées par des nombres).
Exemples : classes d’occupation du sol, types de végétation, types de sols, type d’équipement (hôpital, église, école, etc.)
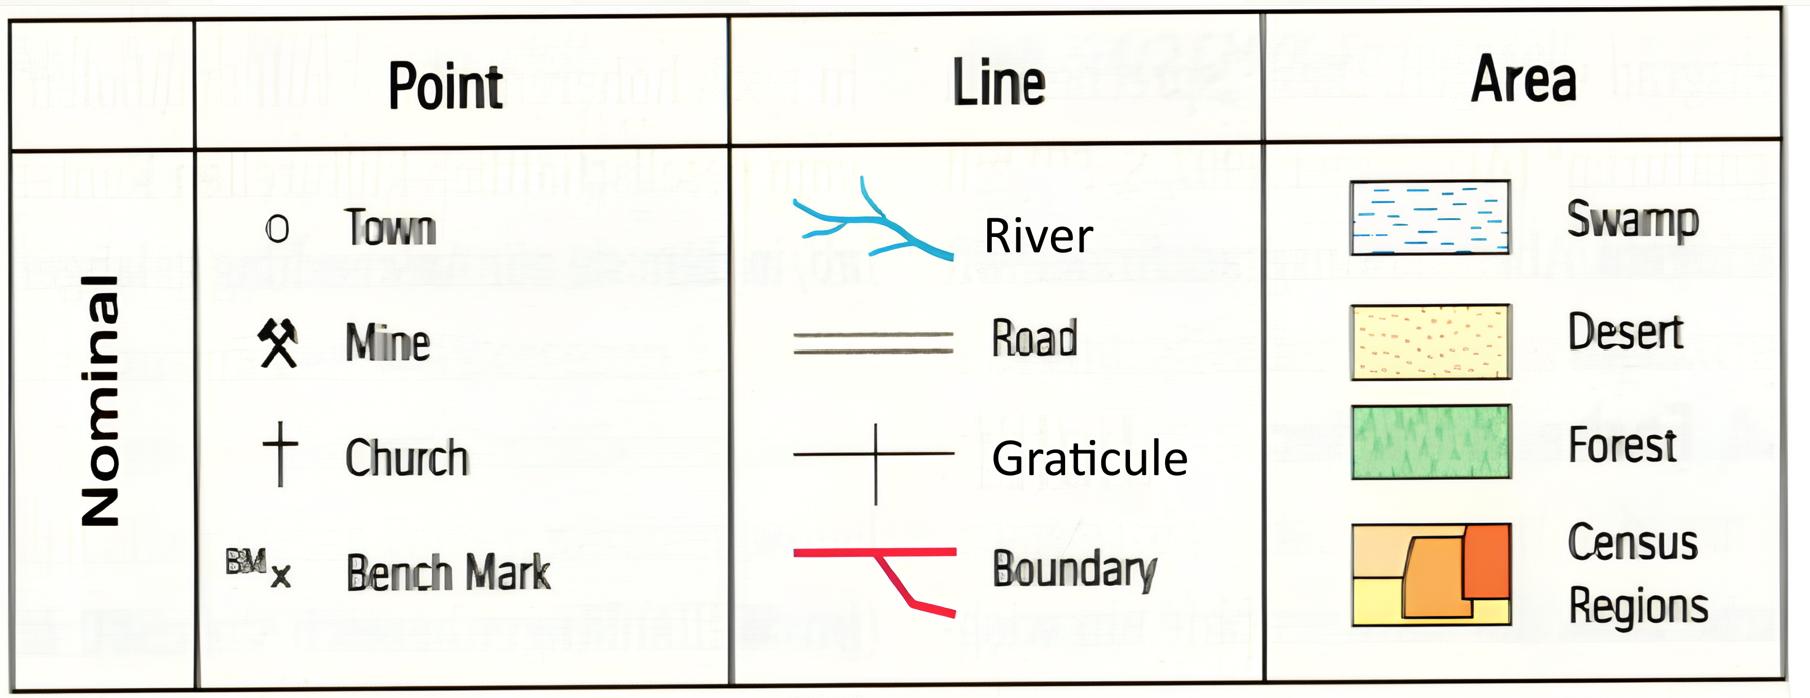
Fig. 3.9 Exemples de données nominales et de leur représentation (Source : Dickmann (2018) Kartographie, Westermann).#
L’échelle ordinale (données classées) consiste également à catégoriser les données, mais ici les catégories possèdent un ordre ou un rang significatif. En revanche, les intervalles entre les rangs ne sont pas nécessairement égaux ni connus. L’ordre de classement est important : les entités peuvent être classées du plus faible au plus élevé, mais l’écart réel entre les rangs n’est pas mesuré. Il est possible de comparer et de classer les données (par exemple, déterminer quelle entité est classée plus haut ou plus bas).
Exemples : aptitude des terres, hiérarchie du réseau routier, classes de taille de population, classes de vulnérabilité (par ex. pour des unités administratives)
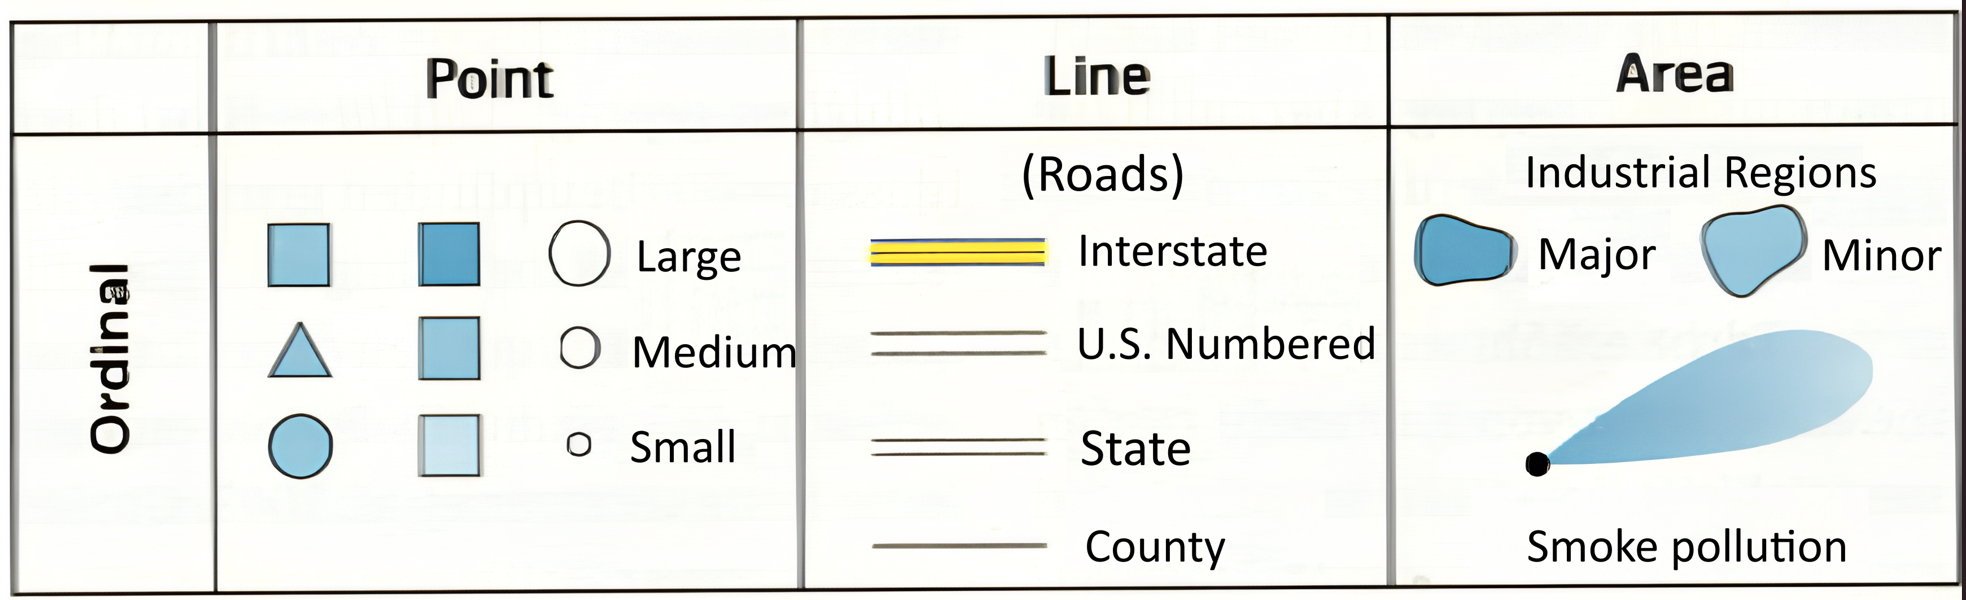
Fig. 3.10 Exemples de données ordinales et de leur représentation (Source : Dickmann (2018) Kartographie, Westermann)#
L’échelle métrique (données quantitatives) concerne des données qui possèdent à la fois un ordre et des écarts exacts entre les valeurs. Les données sont représentées par des valeurs numériques précises et les différences entre ces valeurs sont constantes sur toute l’échelle. Les données métriques peuvent être subdivisées en :
Échelle d’intervalle : données numériques où la différence entre les valeurs est significative, mais sans véritable zéro absolu (par ex. la température en degrés Celsius).
Échelle de rapport : données numériques pour lesquelles les différences et les rapports sont significatifs, avec un véritable zéro absolu (par ex. distance, surface).
Exemples : données d’altitude, distance, surface, données de population.
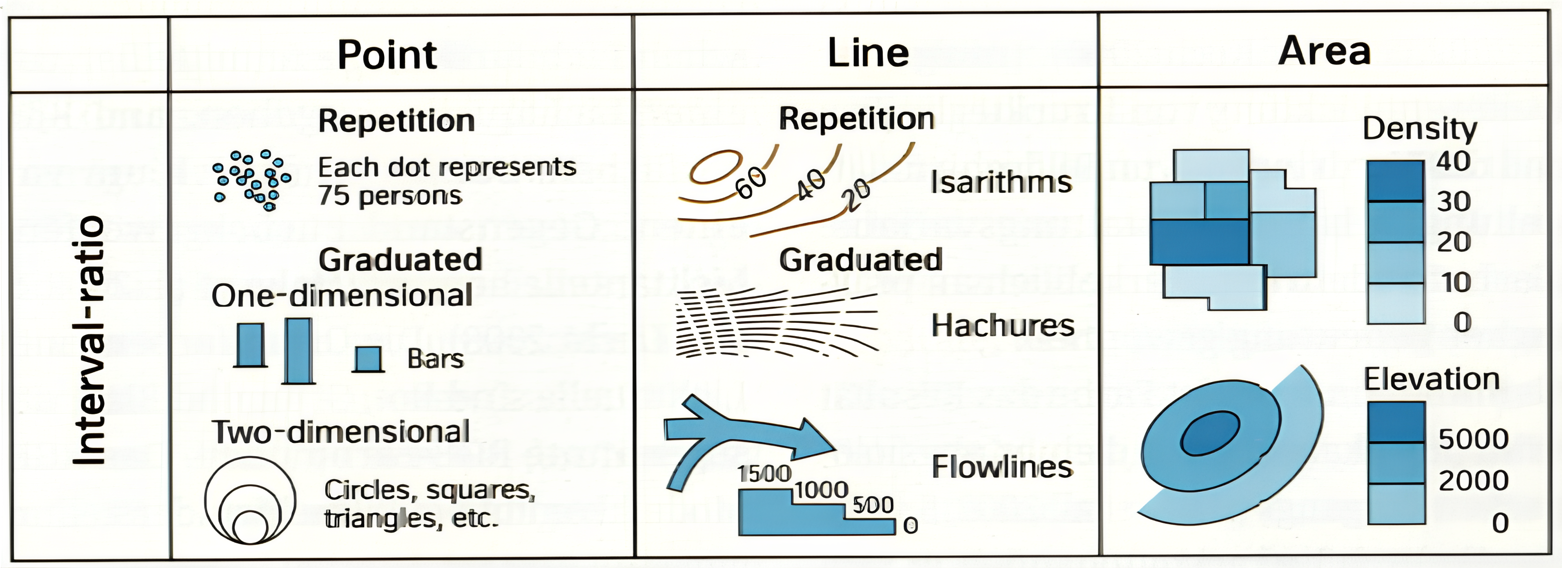
Fig. 3.11 Exemples de données métriques et de leur représentation (Source : Dickmann (2018) Kartographie, Westermann).#
Selon le type d’échelle, vous utiliserez différentes méthodes de classification. Ci-dessous, nous allons passer en revue les différents types de classification disponibles dans QGIS, ainsi que les cas dans lesquels les utiliser. Nous aborderons également plusieurs situations que vous pourriez rencontrer dans votre pratique des SIG.
3.3.2. Classification à symbole unique #
Par défaut, QGIS visualise toutes les couches avec le paramètre Single symbol. Cela signifie que toutes les entités d’une couche sont visualisées de la même manière. Dans ce mode, vous pouvez modifier de nombreux paramètres comme la couleur ou l’opacité, mais vous ne pouvez pas classer les données en plusieurs groupes !
La classification à symbole unique est utile lorsque vous disposez d’un jeu de données simple. Par exemple, vous chargez une couche polygonale contenant les limites administratives d’une région, ainsi qu’une couche ponctuelle contenant les principales villes. Dans ce cas, vous pouvez choisir une classification à symbole unique et ajuster le symbole pour chaque couche.
Comment faire : classification à symbole unique
Pour ajuster le style d’une couche…
Faites un clic droit sur votre couche.
Cliquez sur
Symbology.Vérifiez que le paramétrage de la couche est sur
Single Symbol.Sélectionnez la couleur de votre choix dans le menu déroulant. Pour davantage d’options de couleur, choisissez
Choose Colordans le menu déroulant.Optionnel : vous pouvez ajuster l’opacité/la transparence de la couche. Cela peut être très utile lorsque vous souhaitez afficher plusieurs couches qui se chevauchent.
Optionnel : vous pouvez ici définir le type d’unité. Cela est utile si vous souhaitez visualiser des points avec une certaine taille, par exemple.
Optionnel : vous trouverez ici rapidement des styles standard et des styles précédemment utilisés.
Cliquez sur
Applypour appliquer vos modifications.Cliquez sur
OKpour fermer la fenêtre.
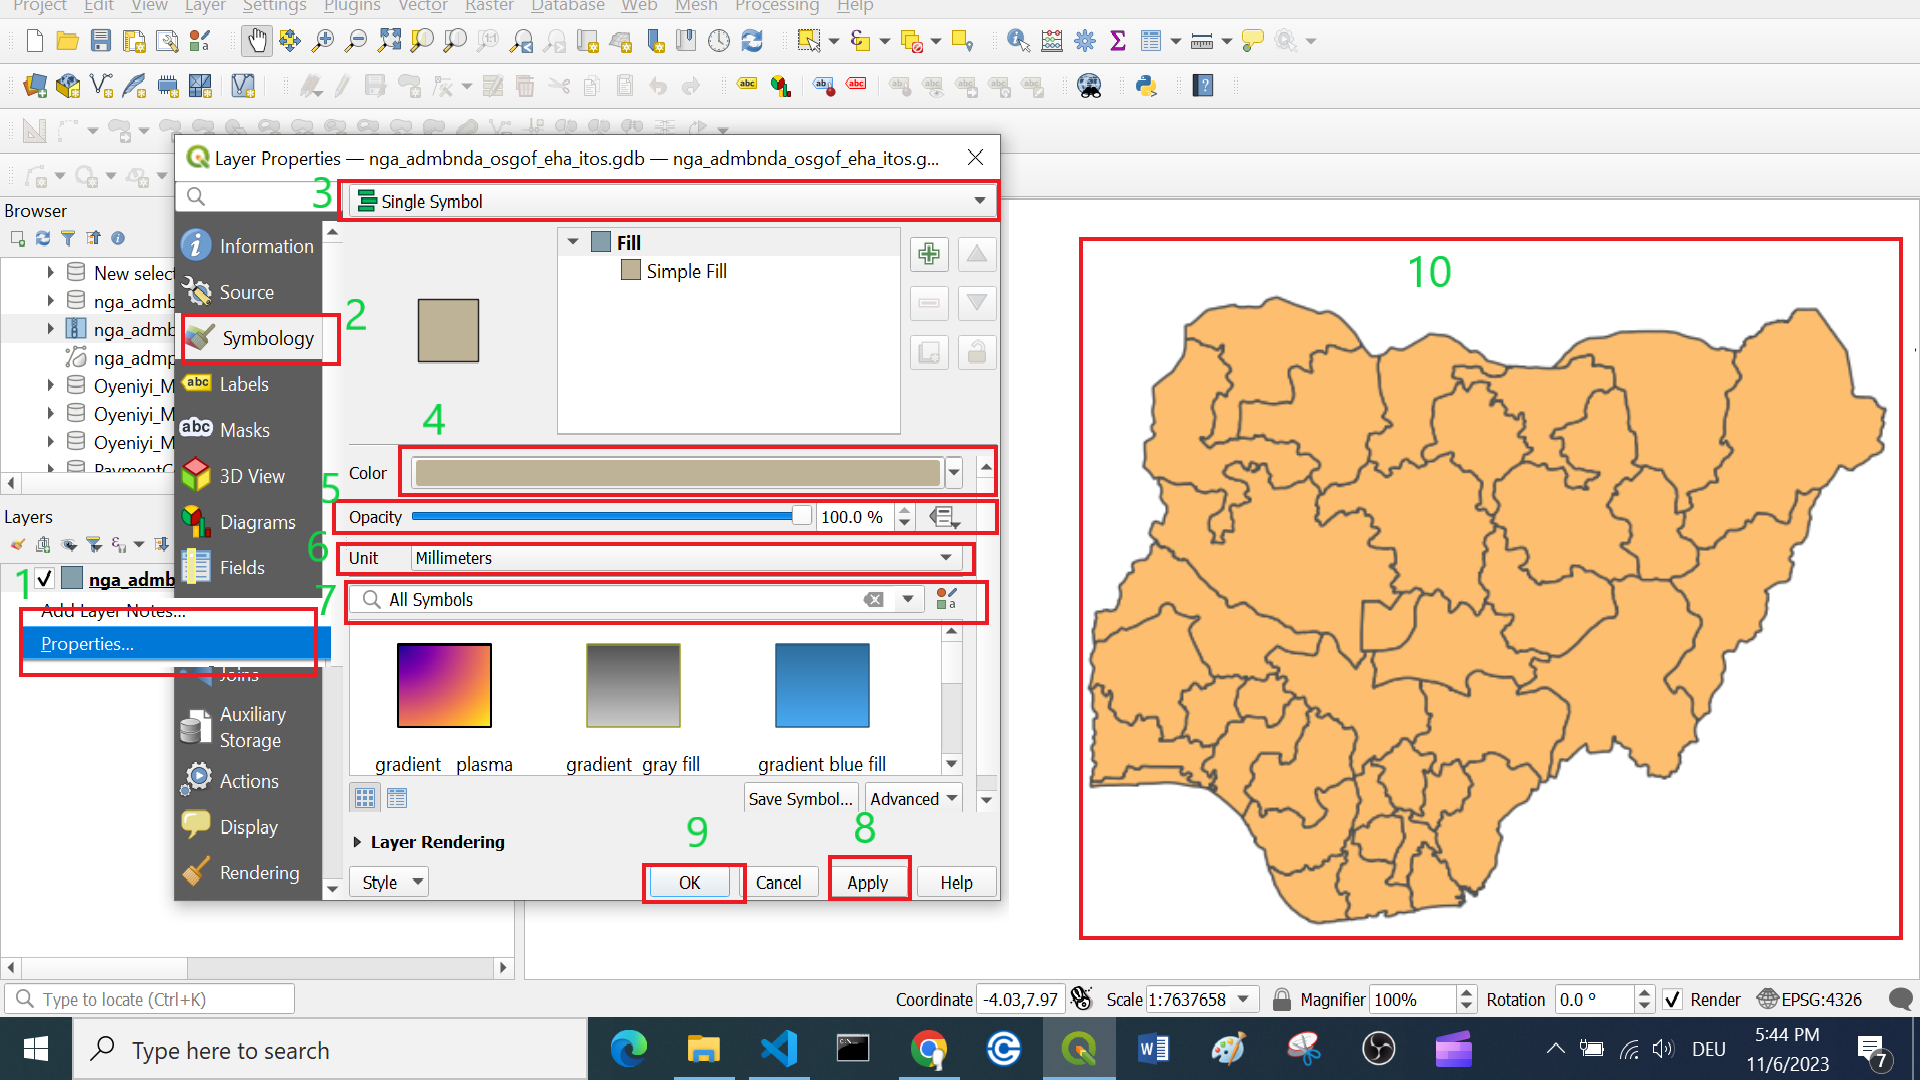
Fig. 3.12 Ajustement du style d’une couche.#
3.3.3. Classification catégorisée #
La classification catégorisée dans QGIS regroupe les données spatiales en catégories distinctes sur la base d’attributs spécifiques.
Cette classification organise les entités en catégories à partir de valeurs spécifiques de la table attributaire. En attribuant un symbole à chaque catégorie, vous facilitez l’interprétation de l’information géospatiale sur votre carte et obtenez ainsi une lecture plus claire.
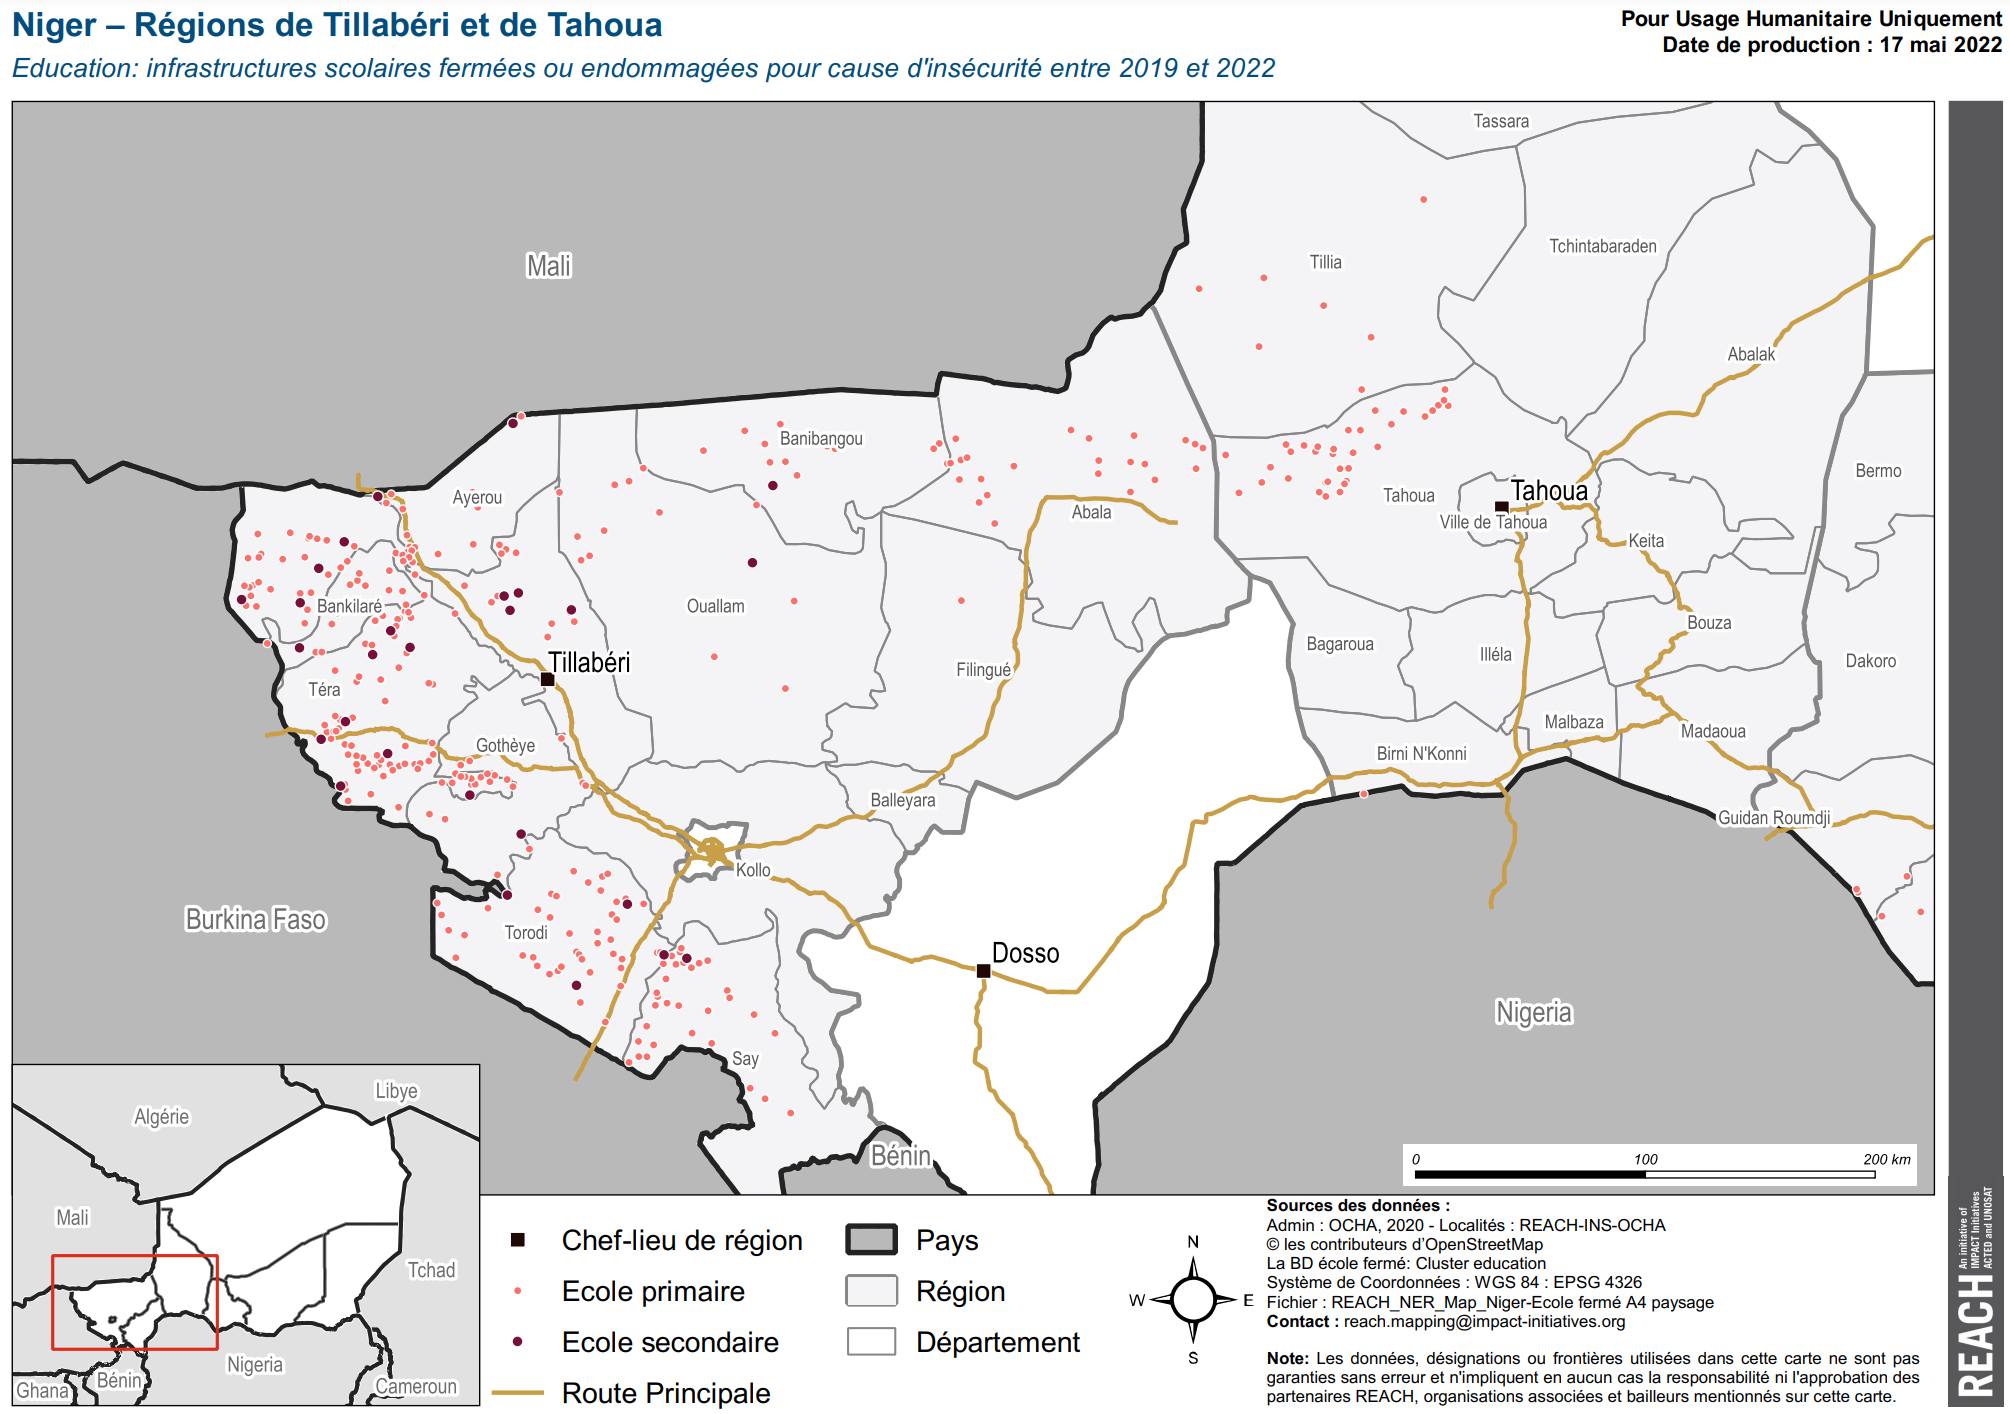
Fig. 3.13 Niger – Carte des régions de Tillabéri et Tahoua montrant les établissements scolaires fermés ou endommagés entre 2019 et 2022 (Source : REACH).#
Sur la carte ci-dessus, les routes principales ont reçu un symbole unique. Les écoles ont été classées en deux catégories : école primaire et école secondaire.
La classification catégorisée est généralement utilisée pour des données d’échelle nominale et ordinale.
Data Scale |
Definition |
Example |
Typical Data Format |
|---|---|---|---|
Échelle nominale |
Catégories sans ordre ni hiérarchie intrinsèques |
Types d’occupation du sol, districts, zones de moyens d’existence |
Texte (“Désert”) ou entier (5) |
Échelle ordinale |
Catégories avec un ordre ou un rang significatif |
Rang (par ex. faible, moyen) |
Texte (“élevé”) ou entier (5) |
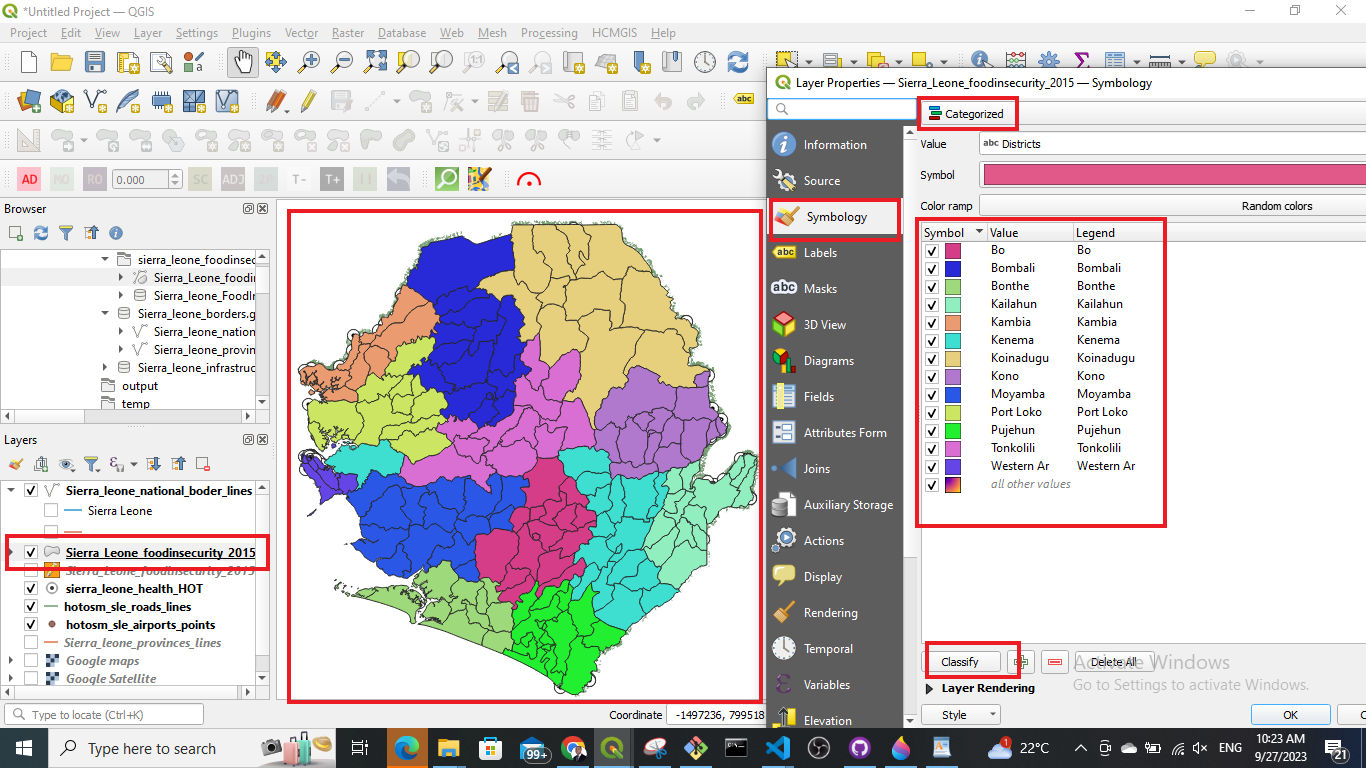
Fig. 3.14 Exemple de carte utilisant une classification catégorisée.#
Comment faire : classification catégorisée
Pour classer les données par catégories…
Faites un clic droit sur votre couche.
Cliquez sur
Symbology.Cliquez sur
Categorized.Dans le menu déroulant
Value, sélectionnez la colonne à partir de laquelle vous souhaitez catégoriser vos données.Plus bas dans la fenêtre, cliquez sur
Classify. Vous devriez maintenant voir toutes les valeurs ou tous les attributs uniques de la colonne sélectionnée dansValue. Pour ajouter ou supprimer des valeurs individuelles, utilisez les boutons-et+.Optionnel : dans le menu déroulant
Symbol, vous pouvez choisir les couleurs et symboles à utiliser.Optionnel : dans le menu déroulant
Color ramp, vous pouvez définir la gamme de couleurs à utiliser.Optionnel : vous pouvez ouvrir le panneau
Layer Renderingen bas de la fenêtre. Vous pourrez y ajuster l’opacité/la transparence de la couche.Cliquez sur
Applypour appliquer vos modifications.Cliquez sur
OKpour fermer la fenêtre.
3.3.4. Classification graduée #
La classification graduée dans un SIG consiste à répartir les données spatiales en classes ou intervalles sur la base d’une progression de valeurs. Cette méthode est particulièrement utile pour visualiser des données quantitatives, car elle permet de différencier des niveaux d’intensité, de densité ou de magnitude sur un continuum, ce qui favorise une représentation nuancée des phénomènes géographiques.
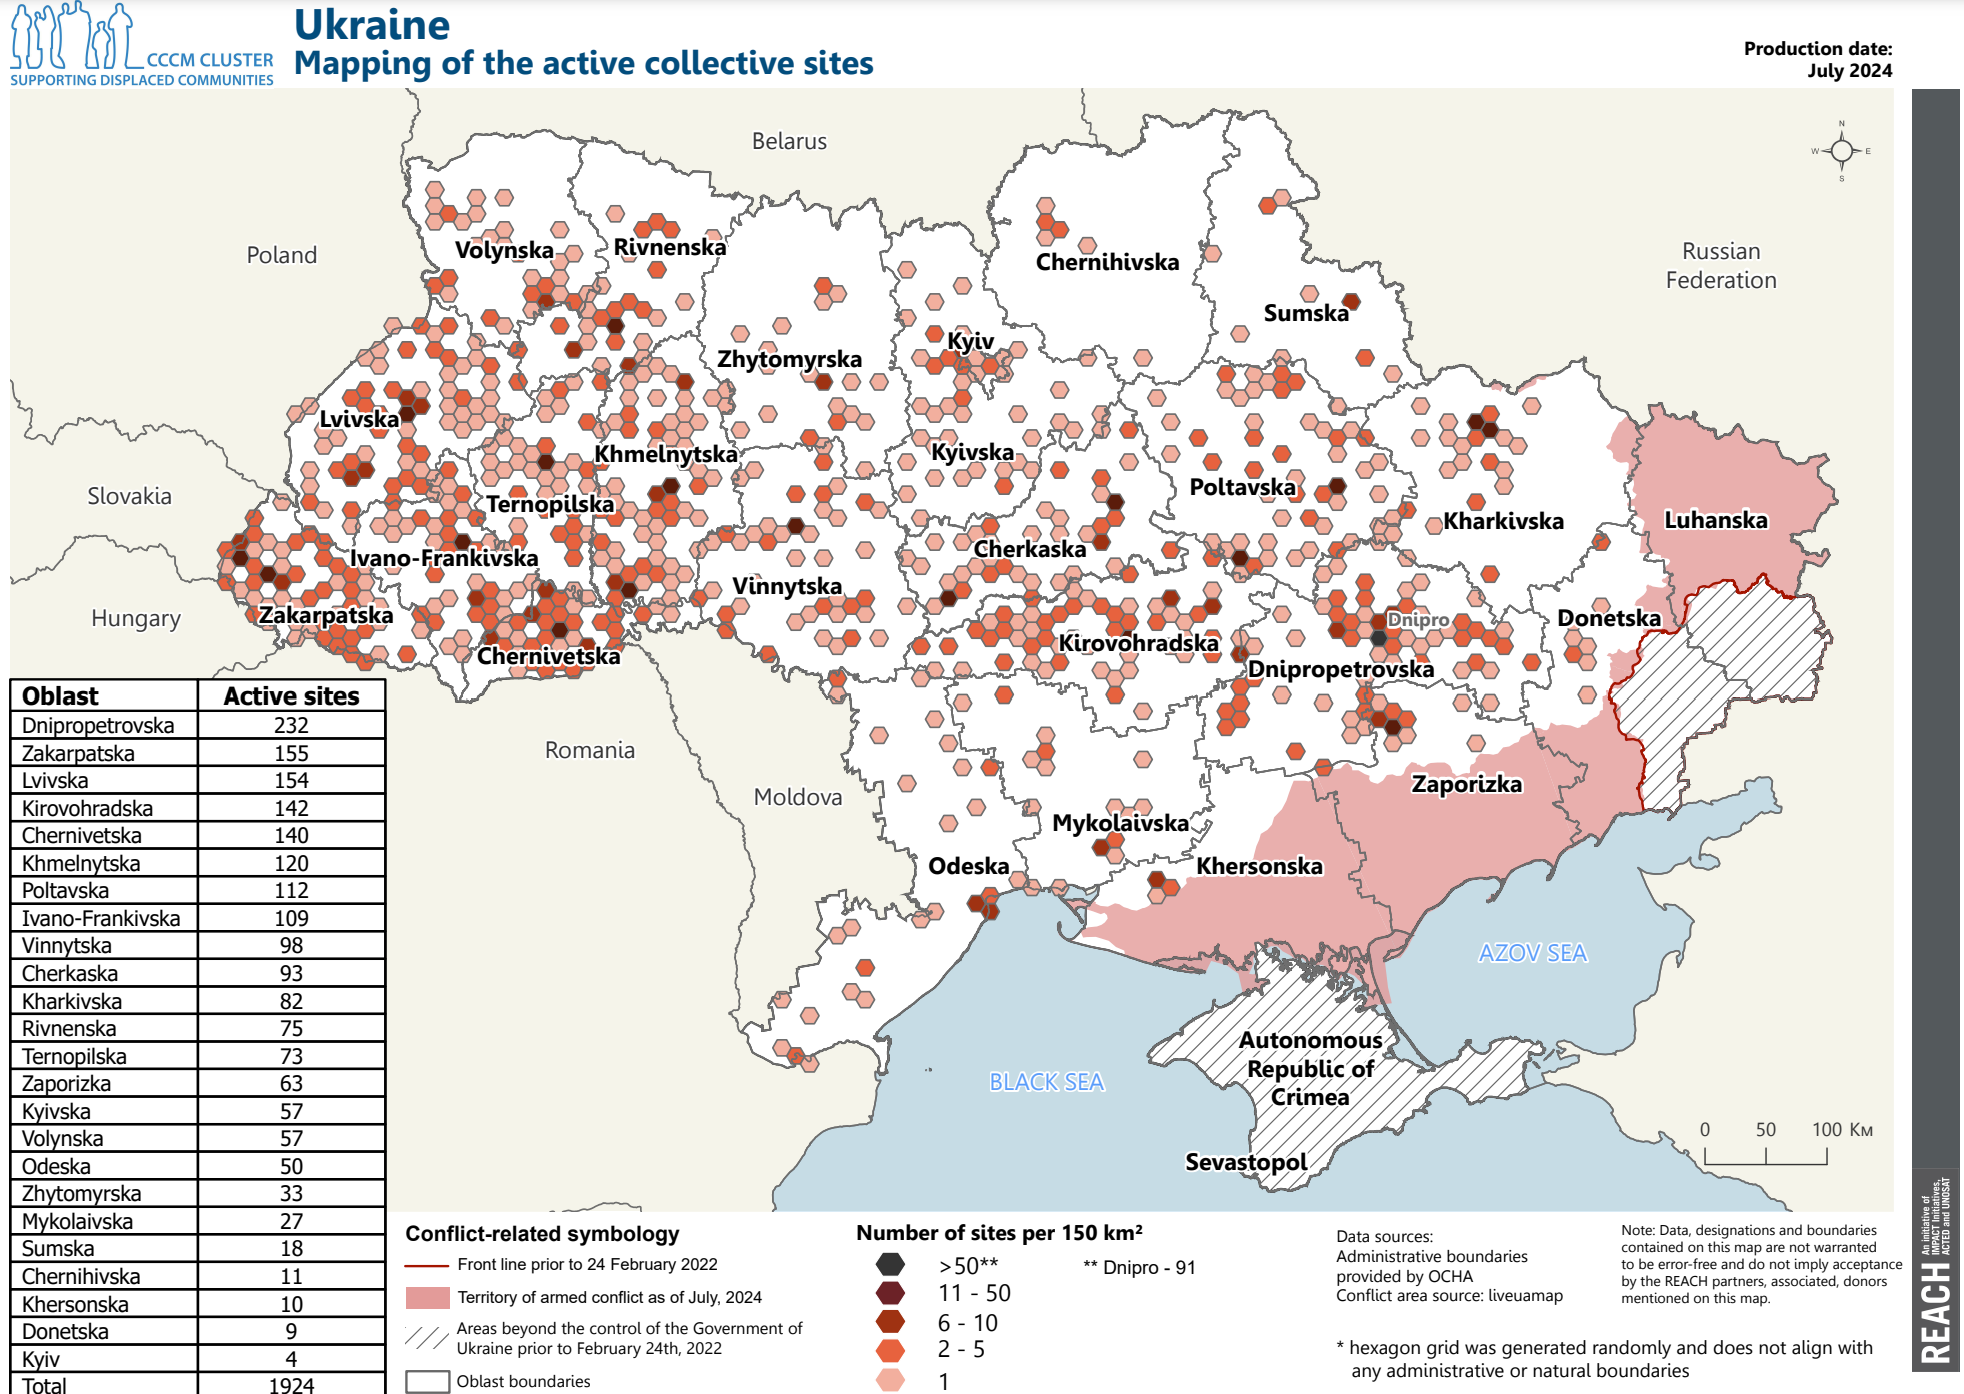
Fig. 3.15 REACH, Ukraine, carte de suivi des sites collectifs pour les personnes déplacées internes, sites actifs, juillet 2024 (Source : Reach).#
Dans Fig. 3.15, chaque cellule hexagonale contient une valeur correspondant au “nombre de sites par 150 km²”, allant de 1 à 91. Les cellules ont été regroupées en 5 catégories, ce qui permet de distinguer facilement les différentes valeurs de chaque cellule. En limitant le nombre de classes, le lecteur peut lire et comprendre la carte plus rapidement.
La classification graduée est généralement utilisée pour des données quantitatives d’échelle d’intervalle ou de rapport.
Data Scale |
Definition |
Example |
Typical Data Format |
|---|---|---|---|
Échelle d’intervalle |
Intervalles égaux entre les valeurs, sans véritable zéro |
Température (Celsius) |
Float (44.5 Degree) |
Échelle de rapport |
Intervalles égaux avec un véritable zéro |
Population, longueur, nombre d’arbres |
Integer (5 Trees) ou Float (12.5 km of Road) |
Pour classer des données quantitatives, il existe de nombreuses méthodes de définition des classes. Il n’existe pas une seule meilleure façon de choisir une méthode ni de décider du nombre de classes à utiliser. Tout dépend de ce que vous souhaitez montrer.
Tip
Un bon intervalle pour le nombre de classes est de 3 à 7. N’utilisez pas plus de 9 classes, car il devient alors difficile de distinguer les classes entre elles, ce qui rend la carte plus difficile à comprendre.
Prenons l’exemple ci-dessous. Vous voyez un histogramme de la population des districts. Cela signifie que nous disposons d’un jeu de données comportant des districts et le nombre d’habitants dans chacun d’eux. Rien qu’à partir de l’histogramme, nous pouvons formuler quelques constats généraux.
Il n’existe aucun district sans population ou avec une population nulle.
Il n’y a que quelques districts avec une très faible population.
Il semble qu’il existe trois grands groupes de districts.

Fig. 3.16 Histogramme des données de population. Source : Axis Maps.#
Cependant, si nous voulons montrer sur une carte quels districts ont une population plus élevée que d’autres, nous devons classer les districts.
Il existe sept façons dans QGIS de répartir des données quantitatives en classes. Les quatre plus importantes sont : Intervalles égaux, Quantiles, Seuils naturels, Manuel. Regardons à quoi ressembleraient les classes de population des districts si nous répartissions les données en trois classes en utilisant ces méthodes.
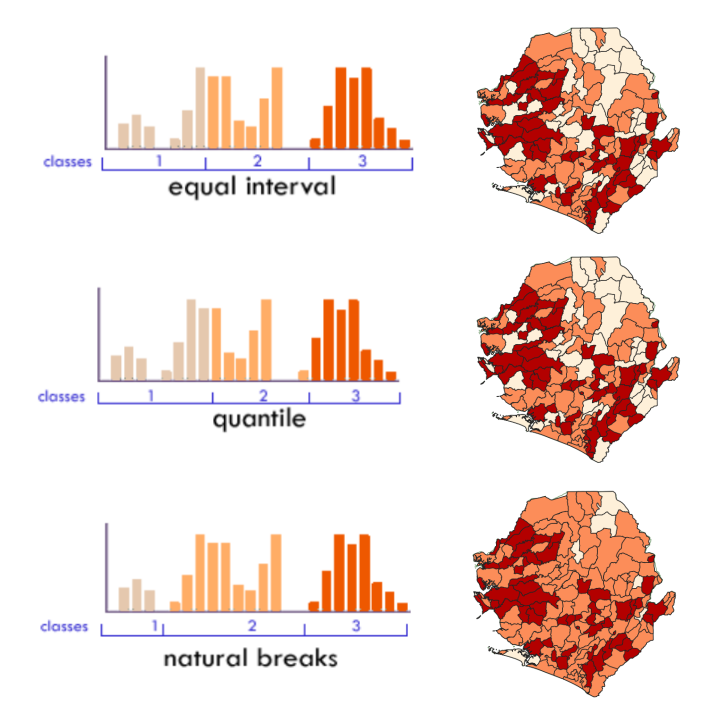
Fig. 3.17 Différentes classifications. Source : HeiGIT (adapté de Axis Maps).#
La classification par intervalles égaux divise les données en classes de taille uniforme, par exemple 0–10, 10–20, 20–30, etc. Elle est efficace pour des données réparties de manière homogène sur toute l’étendue des valeurs. Toutefois, il faut être prudent lorsque les données sont asymétriques ou présentent des valeurs extrêmes importantes, car cela peut conduire à des classes vides. Les données de population utilisées ici, qui ne présentent pas de grandes valeurs extrêmes, conviennent bien à cette méthode.
La classification par quantiles garantit un nombre égal d’observations dans chaque classe, ce qui produit des cartes visuellement équilibrées. Toutefois, elle peut entraîner des classes dont les intervalles numériques sont très différents ; dans certains cas, des valeurs similaires peuvent être séparées tandis que des valeurs différentes sont regroupées ensemble. Il est conseillé d’utiliser un histogramme pour évaluer les éventuels problèmes. Dans l’exemple de population par district, la classification par quantiles a produit une rupture discutable, en intégrant une partie du troisième groupe dans la classe 2 alors que ces observations étaient numériquement plus proches de celles de la classe 3.
La méthode des seuils naturels est une méthode de classification optimale qui vise à minimiser la variance à l’intérieur des classes et à maximiser les différences entre les classes pour un nombre donné de classes. Toutefois, elle produit une solution de classification propre à chaque jeu de données, ce qui peut être un inconvénient lorsqu’on souhaite comparer plusieurs cartes, par exemple dans une série ou un atlas. Dans ce type de cas, un schéma de classification cohérent appliqué à toutes les cartes peut être préférable.
La classification manuelle permet à l’utilisateur de définir un ou plusieurs seuils de classe en fonction de besoins spécifiques. Cette approche est utile lorsqu’il est nécessaire de fixer à l’avance certains seuils, par exemple pour les aligner sur la moyenne ou pour maintenir la cohérence dans une série de cartes. La classification manuelle est recommandée lorsque d’autres méthodes fournissent une bonne solution mais pourraient bénéficier de légers ajustements pour mieux répondre à des besoins particuliers ou à certaines méthodes de visualisation.
La classification en échelle logarithmique est utilisée lorsque les données couvrent plusieurs ordres de grandeur et qu’une échelle linéaire ne représente pas efficacement les variations. Cette échelle applique une transformation logarithmique aux données, en compressant les grandes valeurs tout en étendant les petites. Elle est utile pour visualiser des données présentant une croissance ou une décroissance exponentielle. Toutefois, l’interprétation des valeurs sur une échelle logarithmique peut nécessiter une compréhension plus fine. Envisagez cette méthode lorsqu’il existe une très large plage de valeurs et qu’une échelle linéaire masquerait des structures ou tendances importantes.
La méthode des seuils arrondis est conçue pour produire des cartes visuellement agréables et faciles à interpréter. Elle cherche à générer des seuils de classes correspondant à des nombres « ronds », ce qui rend la carte plus intuitive pour le lecteur. Cette méthode est particulièrement utile lorsqu’on communique des données spatiales complexes à un large public, car elle améliore la clarté et la lisibilité de la carte. Gardez à l’esprit que le choix de seuils « esthétiques » peut dépendre du contexte spécifique et des préférences du public visé.
La classification par écart-type est une méthode qui détermine les seuils de classes à partir de l’écart-type des valeurs des données. Cette approche organise les données en classes en tenant compte de la distribution des valeurs autour de la moyenne. Chaque classe représente un certain nombre d’écarts-types par rapport à la moyenne, fournissant ainsi une base statistique pour catégoriser les données. Cette méthode est efficace lorsqu’on souhaite mettre en évidence la variabilité à l’intérieur du jeu de données. Toutefois, il est important de prendre en compte la nature de la distribution des données et de vérifier si cette méthode correspond bien aux objectifs analytiques de la carte.
Comment faire : classification graduée dans QGIS
La mise en place d’une classification graduée dans QGIS est similaire à celle d’une classification catégorisée. Toutefois, contrairement à la classification catégorisée, vous devez ici décider du nombre de classes et de la méthode de graduation à utiliser.
Pour classer les données en classes…
Faites un clic droit sur votre couche.
Cliquez sur
Symbology.Cliquez sur
Graduated.Dans le menu déroulant
Value, sélectionnez la colonne selon laquelle vous souhaitez classer vos données.En bas à droite, sélectionnez le nombre de classes que vous souhaitez utiliser.
Sous
Mode, sélectionnez la méthode de classification que vous souhaitez utiliser, par exemple Equal count (Quantile).Cliquez sur
Classify. Vous devriez maintenant voir toutes les classes et la distribution des valeurs. Pour ajouter ou supprimer des classes, utilisez les boutons-et+.Optionnel : cliquez sur
Histogram→Load Values. Vous pouvez alors visualiser la distribution exacte des valeurs dans les différentes classes. Cela est très pratique pour choisir une méthode de classification. Vous pouvez également consulter la moyenne et l’écart-type.
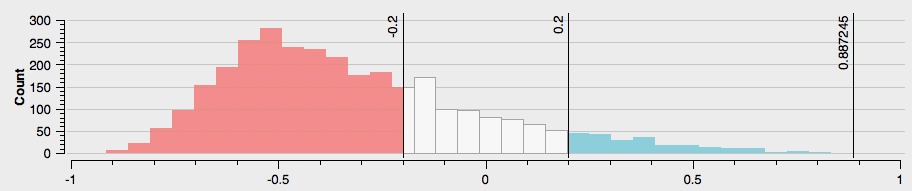
Optionnel : dans le menu déroulant
Symbol, vous pouvez choisir les couleurs et les symboles à utiliser.Optionnel : dans le menu déroulant
Color ramp, vous pouvez définir la gamme de couleurs à utiliser. Pour voir toutes les rampes de couleurs, cliquez sur la flèche duColor ramp→All Color Ramps.Optionnel : sous
Legend Format, vous pouvez ajuster le niveau de précision avec lequel les intervalles de classes seront affichés dans la légende. En général, il est préférable d’éviter d’utiliser des nombres trop complexes dans la légende.Optionnel : vous pouvez ouvrir le panneau
Layer Renderingen bas de la fenêtre. Vous pourrez y ajuster l’opacité/la transparence de la couche.Cliquez sur
Applypour appliquer vos modifications.Cliquez sur
OKpour fermer la fenêtre.
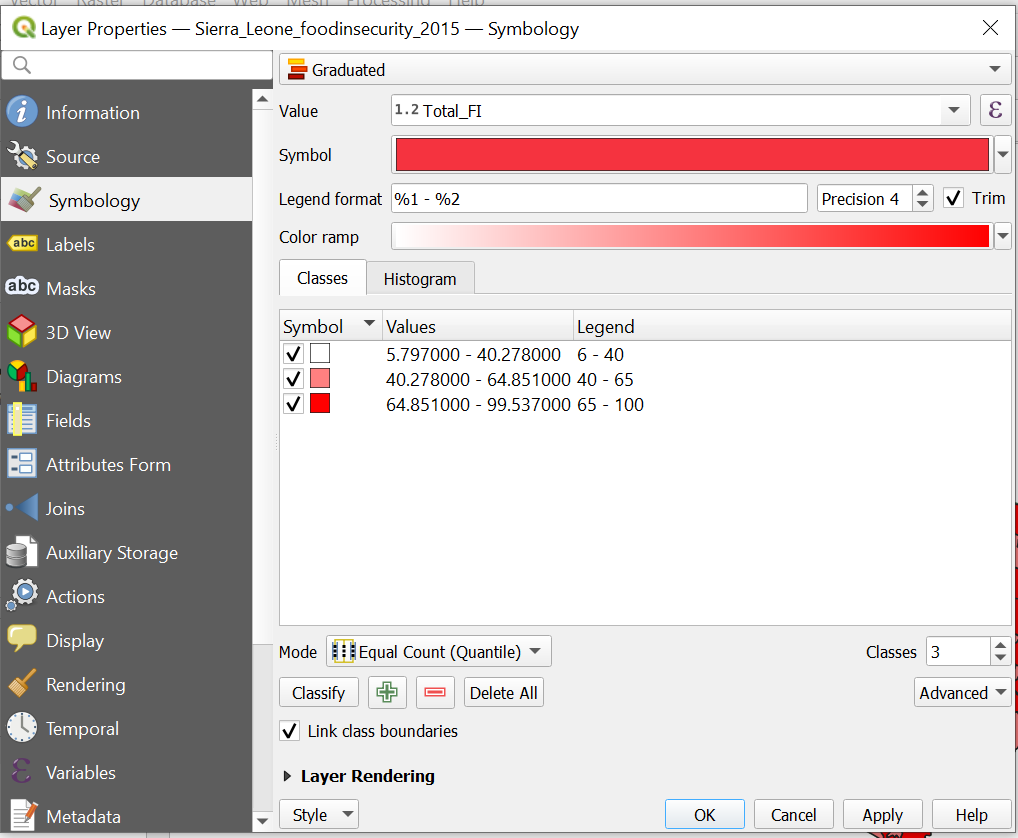
Fig. 3.19 Classification graduée dans QGIS 3.36.#
3.3.5. Questions d’auto-évaluation #
Vérifiez vos connaissances
Qu’est-ce que la classification des données géographiques, et pourquoi est-elle utile dans un SIG ?
Réponse
La classification des données géographiques est le processus qui consiste à regrouper ou catégoriser des entités géographiques selon des valeurs attributaires communes (ou des intervalles de valeurs), puis à attribuer à chaque classe son propre symbole ou sa propre couleur.
Elle permet de visualiser des structures, de rendre les cartes plus lisibles, de distinguer les différences dans les données et de communiquer plus clairement les variations spatiales, en particulier pour des attributs quantitatifs ou catégoriels.
Quelles sont les trois méthodes de classification les plus courantes dans QGIS ? Expliquez leurs différences.
Réponse
QGIS prend en charge les trois modes de classification courants suivants :
Method |
Use case / data type |
How it works / difference |
|---|---|---|
Single symbol |
Pour des jeux de données simples ou lorsque vous souhaitez que toutes les entités aient le même aspect |
Toutes les entités reçoivent le même symbole (couleur, taille). Aucune différenciation par attribut. |
Categorised |
Pour des données nominales ou ordinales (catégorielles) |
Les entités sont regroupées selon les valeurs attributaires uniques (catégories). Chaque catégorie reçoit son propre symbole. |
Graduated |
Pour des données quantitatives / métriques |
Les valeurs numériques sont réparties en classes numériques (intervalles). Chaque classe reçoit une symbologie différente, souvent par rampe de couleur. Vous choisissez le nombre de classes et la méthode de classification (par ex. intervalles égaux, quantiles, seuils naturels). |
Citez trois méthodes différentes pour répartir des données quantitatives en classes. Quelles sont leurs différences ?
Réponse
Method |
Description / how breaks are determined |
Strengths & drawbacks |
|---|---|---|
Equal Interval |
Divise l’étendue complète des données en intervalles de taille égale (par ex. en divisant [min, max] en n intervalles de même largeur) |
Méthode simple et intuitive, mais elle peut produire de nombreuses classes vides ou très peu remplies si les données sont asymétriques ou comportent des valeurs extrêmes. |
Quantile (Equal Count) |
Chaque classe contient approximativement le même nombre d’entités |
Offre un bon équilibre visuel, mais les intervalles numériques des classes peuvent être très différents, et des valeurs proches peuvent être séparées entre différentes classes. |
Natural Breaks (Jenks) |
Utilise un algorithme pour minimiser la variance à l’intérieur des classes et maximiser les différences entre classes (c’est-à-dire trouver des regroupements « naturels ») |
Produit souvent des seuils visuellement pertinents et bien adaptés à la distribution des données. En revanche, les seuils dépendent du jeu de données, ce qui complique les comparaisons entre cartes. |
Quels sont les compromis ou les difficultés liés au choix du nombre de classes dans une classification graduée ?
Réponse
Plus il y a de classes, plus le niveau de détail est élevé, mais trop de classes rendent la carte confuse, car il devient difficile de distinguer les couleurs ou les nuances subtiles. Le module recommande de rester entre 3 et 7 classes, et de ne pas dépasser 9.
Si le nombre de classes est trop faible, vous risquez de trop simplifier les données et de masquer des variations importantes ou des valeurs extrêmes.
Si le nombre de classes est trop élevé, la carte devient chargée, les couleurs trop proches les unes des autres, et l’interprétation devient plus difficile.
La distribution des données est également importante : des données très asymétriques ou avec des valeurs extrêmes peuvent fausser les intervalles de classes, de sorte que la majorité des entités se retrouve concentrée dans quelques classes, tandis que d’autres restent presque vides.
Pour des cartes comparatives (par ex. une série de cartes), utiliser des seuils différents pour chaque carte parce que les données diffèrent peut réduire la comparabilité ; des seuils fixes améliorent la cohérence mais ne sont pas toujours adaptés à la distribution spécifique de chaque jeu de données.